ChatGPTに「〇〇のおすすめは?」と聞くと、競合の商品は出てくるのに自社の商品は出てこない。商品ページを作り込んだのに、AIの答えの出典に公式サイトが載らない。最近、EC事業者の方からよくいただく相談です。
商品ページを見直す前に、確かめておきたいことがあります。AIがそもそも自社サイトを読めているかどうかです。不正注文対策やサーバーの初期設定の影響で、知らないうちにAIまで締め出していた、というケースもあります。
この記事で分かること
- AIに読まれていないと、売上やブランドにどう響くか
- AIを止めている5つの原因と、自分で確かめる方法
- 制作会社や情報システム部門への頼み方
- 直した後の成果の測り方
結論
AIクローラーのブロック確認とは、AIがサイトを読みに来たとき、入口で止められていないかを確かめる作業です。見るべき場所は次の5つです。
- robots.txt(検索エンジンやAIのクローラーに、アクセスを許可する範囲を伝えるファイル)
- CDN・WAF(サーバーの手前でアクセスを守る仕組み)
- ECカートやサーバーのボット対策(不正注文を防ぐための自動ブロックや確認画面)
- ページやGoogleの設定(商品ページの「検索結果に使わない」指定や、Search ConsoleのAI向けの設定)
- 商品情報の表示のしかた(説明文や価格を、ページを開いた後にプログラムで表示している作り)
1と4、それに5の一部は、ECやWebマーケティングの担当者でも自分で確かめられます。2と3は、制作会社や情報システム部門に頼みましょう。記事の後半に、そのまま送れる依頼文を用意しました。
※当社プレティアジャパンは、AIの答えでの言及・引用を計測する「genrank」と、ECサイト向けのエージェンティックコマースAI「genser」を提供しています。当社の立場で書いた記事ですが、手順は特定の製品がなくても進められます。
AIに読まれていないと、何が起きるか
AIに読まれていないと、AIの答えのなかで自社の商品は比べる対象にすら入りません。具体的には、次の3つの機会を逃します。
1. AIの「おすすめ」に入りにくくなる
ChatGPTやGeminiは、答えを作るときにWebページを読みに来ます。読めなかったページの商品は、おすすめの候補に挙がりにくくなります。OpenAIも、検索用のクローラーを拒否したサイトはChatGPTの検索の答えに表示しない、と説明しています。
2. 名前は出ても、公式サイトが出典にならない
AIの答えに自社の名前が出ても、その出典が公式サイトとは限りません。当社の業界別調査でも、名前が出るかどうかと、公式サイトが出典に選ばれるかどうかは、別々の結果になりました。詳しくは、「ドラッグストア10社のAI回答を調査」で紹介しています。公式サイトが読めなければ、AIは比較サイトや口コミサイトをもとに答えるしかありません。その結果、価格や仕様が古いまま伝わるおそれもあります。
3. AIに商品の比較を頼まれたとき、候補から外れる
「この商品ページを見て比べて」とAIに頼むと、AIはその場でページを読みに行きます。消費者の代わりにAIエージェントが商品を探す使い方も広がってきました。AIが商品ページを読めないと、購入直前の比較から外れてしまいます。
AIのクローラーは3種類ある
AIのクローラー(Webページを自動で読みに来るプログラム)には、目的の違う3つの種類があります。止めても困らないものと、止めると困るものがあります。
| 種類 | 何をしに来るか | 止めるとどうなるか | 主な名前 |
|---|---|---|---|
| 学習用 | AIモデルの学習に使う文章を集める | 今後の学習に使われなくなるが、AI検索の答えには直接影響はない | GPTBot、ClaudeBot、Google-Extended |
| 検索用 | AI検索の答えに使うページを集めておく | その会社がAI検索の答えに出にくくなる | OAI-SearchBot、Claude-SearchBot、PerplexityBot |
| ユーザー操作用 | 利用者に頼まれて、その場でページを読む | 回答中に自社のページを読んでもらえなくなる | ChatGPT-User、Claude-User、Perplexity-User |
ECサイトにとって大切なのは、検索用とユーザー操作用です。学習用を止めるかどうかは、自社の方針で決めて構いません。学習用を止めても、AI検索の答えに出る機会はなくなりません。
ユーザー操作用のAIには、robots.txtの指定が当てはまらないものもあります。OpenAIはChatGPT-Userについて当てはまらない場合があるとし、PerplexityはPerplexity-Userが原則として従わないと説明しています。こうしたAIを止めているのは、主にCDN・WAFやボット対策です。
GoogleのAIによる概要とAIモードは、Google検索の一部です。AIによる概要に使われるかどうかは、通常のGoogleのクローラーと、Search Consoleの設定で決まります。
AIのクローラーを止めている5つの原因と、確かめ方
AIのクローラーを止めている原因は、robots.txt、CDN・WAF、ECカートのボット対策、ページとGoogleの設定、商品情報の表示のしかたの5つです。AIのクローラーは、商品ページにたどり着くまでに、これらの関門を外側から順に通ります。手前の関門で止められると、奥の商品ページをどれだけ整えてもAIには読まれません。確認も手前から順に進めましょう。
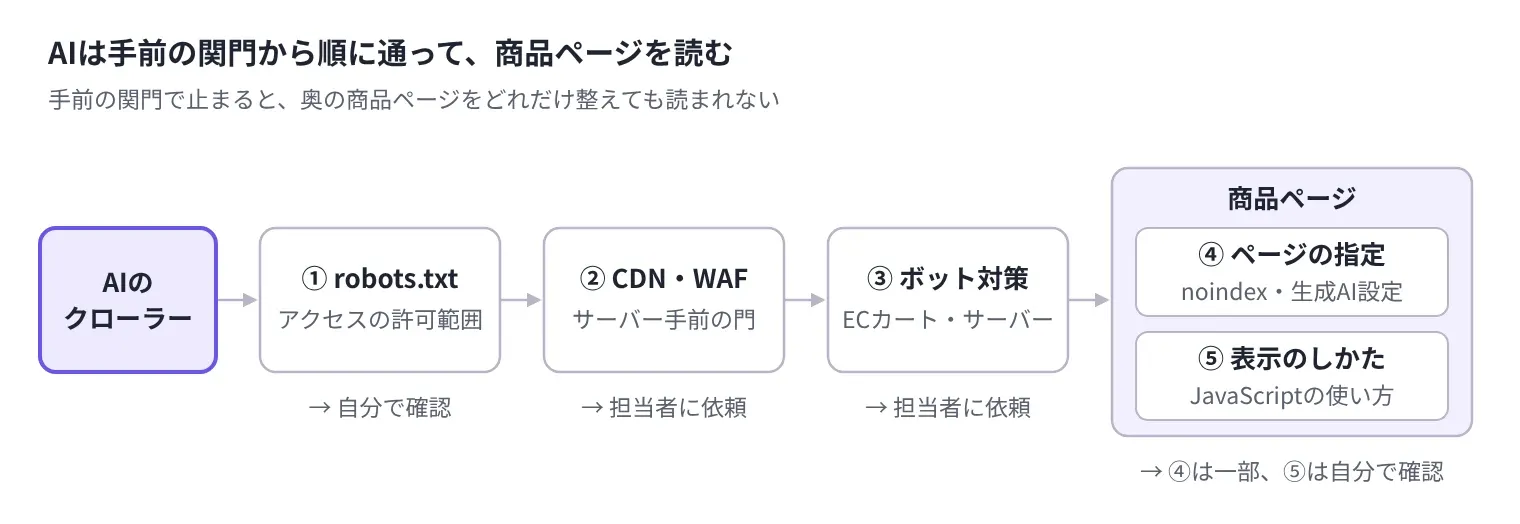
5つの原因のうち、自分で確かめられるのは一部だけです。残りは、サーバーやECカートの設定を触れる人でないと確認できません。そこで下の表では、自分で確かめることと、誰に頼めばよいかを分けています。
| 原因 | 何が起きているか | 自分で確かめること | 社内に頼むこと |
|---|---|---|---|
| 1. robots.txt | AIのクローラーにアクセスを許可していない | ブラウザで開いて読む | 書き換え(制作会社・Web担当) |
| 2. CDN・WAF | サーバーの手前の門で、AIのアクセスを断っている | できない | 設定の確認(情報システム・制作会社) |
| 3. ECカート・サーバー | 不正注文を防ぐ仕組みに、AIも止められている | できない | 設定とアクセス記録の確認(カート事業者・情報システム) |
| 4. ページとGoogleの設定 | AIの答えに使わないよう指定している | Search Consoleの設定を見る | 商品ページの指定の確認(Web担当・制作会社) |
| 5. 商品情報の表示のしかた | 説明文や価格が、AIのクローラーから見えない作りになっている | ブラウザの設定を変えて商品ページを見る | 作りの見直し(開発担当) |
原因1:AI向けの案内ファイル(robots.txt)――ブラウザで開いて自分で読める
robots.txtは、検索エンジンやAIのクローラーに、どのページへのアクセスを許可するかを伝えるファイルです。ブラウザのアドレス欄に「https://自社のドメイン/robots.txt」と入力すれば、誰でも中身を読めます。
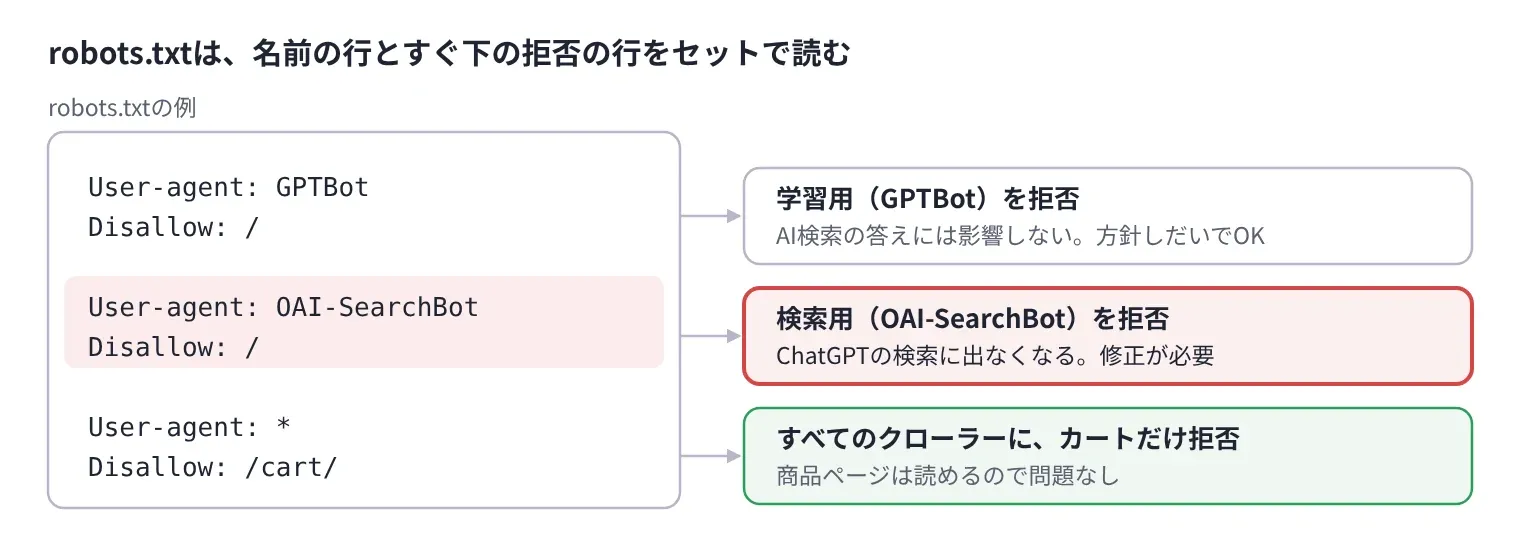
中身は英語の記号のような書き方ですが、見るのは2つの言葉だけです。「User-agent」はクローラーの名前、名前のすぐ下の「Disallow」は「ここは読まないで」という意味です。「Disallow: /」と書かれていたら、サイト全体を読まないで、という意味になります。読み方の例を図にしました。
許可されている状態(問題なし)
次のどれかに当てはまれば、検索用のAIクローラーは商品ページを読めます。
- 検索用のクローラー(OAI-SearchBot・Claude-SearchBot・PerplexityBot)の名前の下に「Allow: /」がある
- 検索用のクローラーの名前が書かれておらず、「User-agent: *」(「*」は、名前を書いていないすべてのクローラー)の下にも「Disallow: /」がない
- 拒否しているのが、カートやマイページなど一部のページだけ(例:「Disallow: /cart/」)
- robots.txtのファイル自体がない(開くと「ページが見つかりません」と表示される)
拒否されている状態(修正が必要)
- 検索用のクローラーの名前の下に「Disallow: /」がある
- 検索用のクローラーの名前が書かれておらず、「User-agent: *」の下に「Disallow: /」がある
自分でできること、担当者に頼むこと
| 作業 | 誰がやるか |
|---|---|
| robots.txtを開いて、許可・拒否の状態を確かめる | 自分でできる |
| robots.txtを書き換える | 制作会社かWeb担当に頼む。ECカートによっては管理画面から編集できるものもあるので、編集できるかどうかをカート事業者に確認する |
拒否されていた場合は、検索用とユーザー操作用のクローラーを許可するよう、制作会社かWeb担当に書き換えを頼みます。頼むときは、記事後半の「社内への確認依頼文」を使うと、意図が伝わりやすくなります。
ネットショップだけ「shop.〜」のような別のアドレスで運営している場合は、ネットショップ側のrobots.txtも開いてください。robots.txtは、アドレスごとに別のファイルです。
原因2:サイトの手前の防御サービス(CDN・WAF)――画面からは見えないので、担当者に聞く
CDN・WAFは、サイトの手前に置いて、表示を速くしたり、攻撃を防いだりするサービスです。不審なアクセスをサイトに届く前に止める、門番のような役割をしています。この門番がAIのクローラーまで止めていると、robots.txtで許可していても、AIは商品ページに届きません。止めた記録はサイト側に残らないので、気づきにくい原因です。
代表的なサービスが、Cloudflare(クラウドフレア)です。調査会社W3Techsによると、Webサイトのおよそ4分の1がCloudflareを使っています。自社で契約した覚えがなくても、制作会社やサーバー会社を通じて使っていることがあります。
Cloudflareは2026年7月から、AIのアクセスを次の3種類に分けて、種類ごとに許可するか拒否するかを決める方式になりました。
| 種類 | どんなAIか | ECサイトでのおすすめ |
|---|---|---|
| 検索(Search) | AI検索の答えに使うページを集める | 許可する |
| 学習(Training) | AIの学習用に文章を集める | 自社の方針で決める |
| エージェント(Agent) | ユーザーに頼まれて、その場でページを読む | 許可する |
注意したいのは、9月15日の切り替えです。以前の「AIボットをまとめて止める」設定を使っていたサイトは、この日に新しい設定へ自動で移され、エージェントが「広告のあるページでは止める」になっています。自社で設定を触っていなくても、AIへの対応が変わっているかもしれません。
学習だけを断りたい場合は、学習の設定を「Block」ではなく「Disallow AI Training」(9月15日に追加された設定)にしてください。「Block」を選ぶと、Googleの通常のクローラーまで止まり、Google検索にも影響します。
自社サイトがCloudflareなどを使っているかどうかも含めて、情報システム部門か制作会社に確認してもらいましょう。依頼するときは、「検索とエージェントは許可、学習は自社の方針どおり」という希望もあわせて伝えてください。robots.txtとCDNは、同じ方針にそろえてもらう必要があります。片方だけ直しても、もう片方で止まったままになるからです。
原因3:ECカート・サーバーのボット対策――不正注文対策でAIまで止めている
ECサイトには、不正注文やカードの不正利用を防ぐため、プログラムによる機械的なアクセスをはじく仕組みがよく入っています。AIのクローラーもプログラムなので、不正なアクセスと同じように止められてしまうことがあります。
よくあるのは次の3つです。
- 商品ページを開くと、「私はロボットではありません」のような確認画面が出る。Anthropicは、確認画面を突破しないと明言しています
- 海外からのアクセスを制限している。Vercelの2024年の調査では、主要なAIクローラーはすべて米国のデータセンターからアクセスしていました
- 短時間にアクセスが集中すると、自動で止める
どの仕組みも、画面を見ただけでは分かりません。カート事業者か情報システム部門に、設定とアクセス記録を確認してもらってください。
原因4:ページとGoogleの設定――Search Consoleは自分で見られる
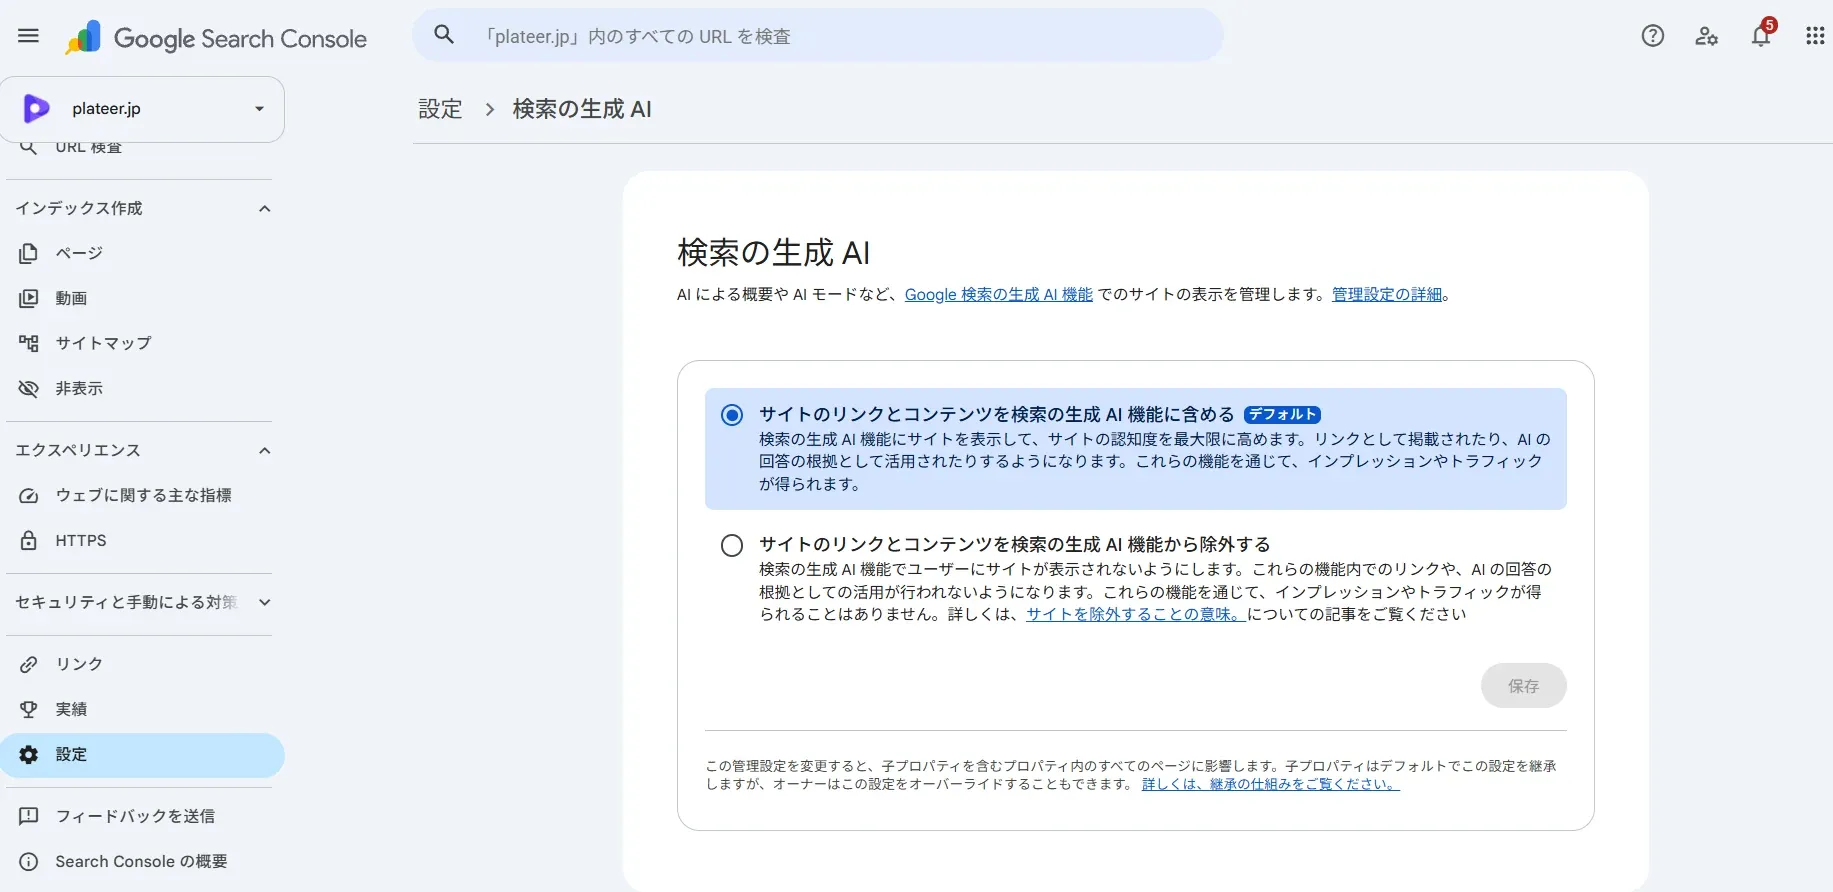
Search Console(Googleが無料で提供しているサイト管理ツール)には、GoogleのAIによる概要とAIモードにサイトを含めるかどうかを選ぶ設定があります。確かめる手順は次のとおりです。
- Search Consoleを開き、自社サイトを選ぶ
- メニューの[設定]を開く
- [検索の生成 AI]を開き、「サイトのリンクとコンテンツを検索の生成 AI 機能に含める」が選ばれているかを見る
※Google Search Console は Google LLC の商標です。
初期設定は「含める」です。「サイトのリンクとコンテンツを検索の生成 AI 機能から除外する」が選ばれていると、Googleで「〇〇 おすすめ」と調べた人に、AIによる概要の中で自社サイトが紹介されなくなります。通常の検索結果には、これまでどおり表示されます。
生成AIの設定は、上位のサイトの設定を引き継ぐ仕組みです。自分で触った覚えがなくても、一度は確認しておきましょう。なお、Googleは、生成AIの設定を通常の検索順位には使わないと説明しています。
もう1つは、商品ページに入っている「検索結果に抜粋を出さない」という指定です。代表的なのは「nosnippet」という指定で、ページのHTMLにこの言葉が入っていると、そのページはAIによる概要に使われません。サイトの作りを変えたときに入ったまま、気づかれていないこともあります。指定があるかどうかは、Web担当か制作会社に確認してもらってください。
原因5:商品情報の表示のしかた――ブラウザで自分で確かめられる
ECサイトでは、価格・在庫・レビュー・仕様を、ページを開いた後にJavaScriptというプログラムで読み込んで表示する作りがよくあります。ところが2024年のVercelの調査では、ChatGPTやClaudeのクローラーはJavaScriptを実行していませんでした。2026年9月下旬から、OpenAIのクローラーが一部のサイトでJavaScriptを実行し始めたという開発者の報告もありますが、OpenAIからの公式な説明はありません。どのAIにも確実に読んでもらうには、JavaScriptに頼らない作りにしておくのが安全です。
人が見る画面と、AIのクローラーが見る画面の違いを図にしました。
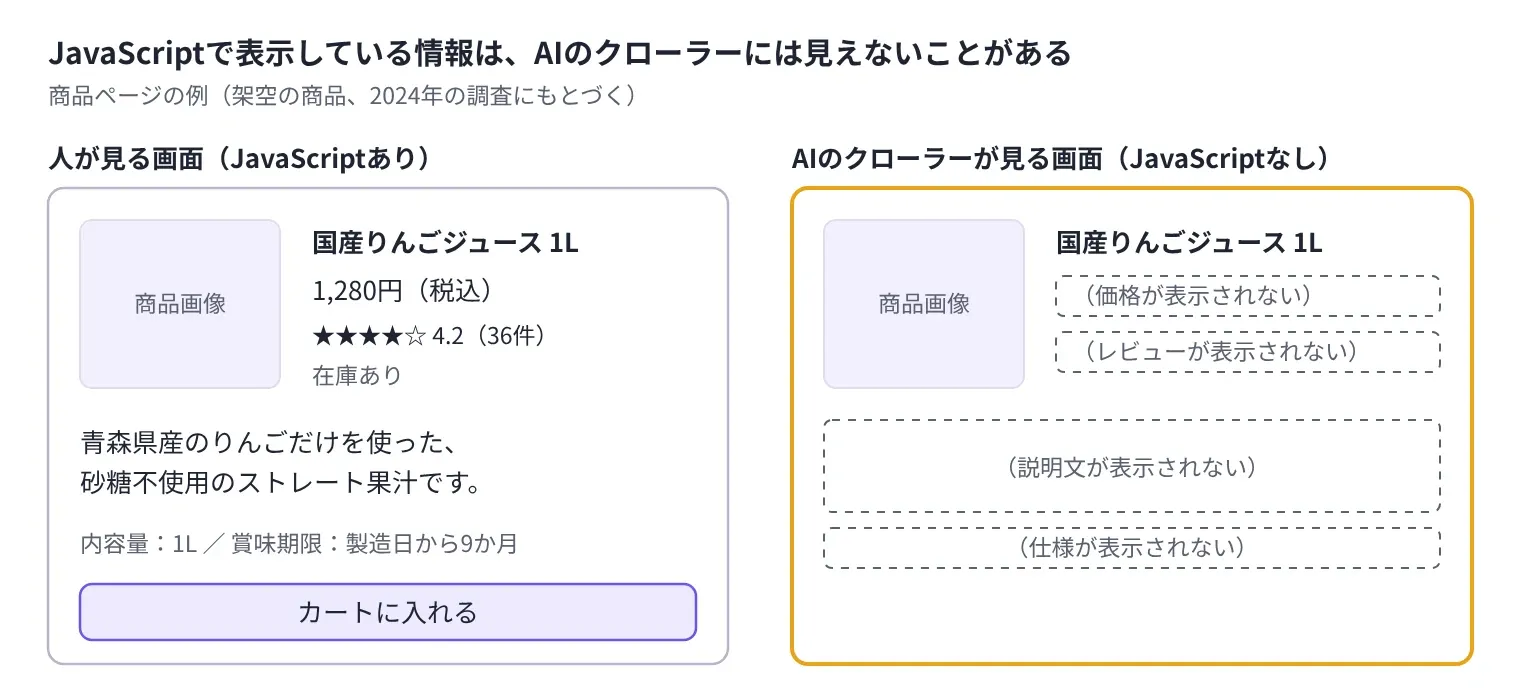
確かめ方は簡単です。ブラウザでJavaScriptを止めてから、商品ページを開いてみてください。Google Chromeなら、[設定]>[プライバシーとセキュリティ]>[サイトの設定]>[JavaScript]で止められます。説明文や価格が消えたら、消えた情報はAIのクローラーにも見えていないと考えてよいでしょう。確認が終わったら、JavaScriptの設定は元に戻してください。
直すには、重要な情報を最初からページのHTMLに入れておく作りに変える必要があります。開発担当に相談しましょう。AIに伝わる商品説明の書き方は、「構造化データを足すだけでは、AIに引用されない」で解説しています。
そのまま使える、社内への確認依頼文
原因2と3は自分では確かめられないので、担当者に頼むのが近道です。下の文面をコピーして、必要に応じて書き換えてください。依頼と一緒にこの記事のURLを送ると、話が早く進みます。
制作会社・情報システム部門へ
件名:AIのクローラーが当社サイトを読めているかの確認のお願い

お疲れさまです。
ChatGPTやPerplexityなどのAI検索で、当社の商品や公式サイトが紹介されるようにしたいと考えています。
まずはAIのクローラーがサイトを読めているかを知りたいので、次の4点を確認していただけますか。

1. robots.txtで、OAI-SearchBot・Claude-SearchBot・PerplexityBot・ChatGPT-User・Claude-Userを拒否していないか
2. CDN・WAF(Cloudflareなど)で、AI向けのボットを止める設定になっていないか(検索・学習・Agentそれぞれの設定値)
3. 直近1か月のアクセス記録に、上記のクローラーが来ているか。来ていれば、正常に表示できているか(応答コード)
4. 商品ページに、noindexやnosnippetの指定が入っていないか

当社の方針は「検索用とユーザー操作用は許可する。学習用は〇〇(許可する/断る)」です。
方針と違う設定があれば教えてください。
ECカート事業者へ
件名:AIのクローラーへの対応についてのご確認

いつもお世話になっております。
当社のネットショップについて、次の点を教えていただけますか。

1. 不正注文対策などのボット防御で、ChatGPTやPerplexityなどのAIのクローラーを止めていないか
2. 商品ページで、確認画面(CAPTCHA)や海外からのアクセス制限が働いていないか
3. 特定のクローラーだけを、ボット防御の対象から外せるか
4. 当社でアクセス記録を確認する方法はあるか
直した後の成果の確かめ方:3段階で見る
成果は、「読まれているか」「答えに出ているか」「お客様が来ているか」の3段階で確かめます。入口を開けただけで、AIの答えに出るようになるわけではないからです。直す前の状態を記録しておけば、変化を比べられます。
| 段階 | 確かめること | 方法 | 担当 |
|---|---|---|---|
| 1. 読まれているか | 検索用のクローラーが、商品ページを問題なく読めているか | サーバーやCDNのアクセス記録を見る | 情報システム・制作会社 |
| 2. 答えに出ているか | 狙った質問の答えに自社名が出るか、公式サイトが出典になるか | 同じ質問をAIに聞いて、定期的に記録する。GoogleについてはSearch Consoleの生成AIのレポートも使える | MD・Webマーケ |
| 3. お客様が来ているか | AIの答えから、サイトへの訪問や購入につながっているか | アクセス解析で、ChatGPTやPerplexityなどからの訪問を見る | Webマーケ |
2段階目では、まず狙う質問を決めます。「子どもが食べやすい、辛くないキムチは?」のように、お客様が実際にAIに聞きそうな言い方で10問ほど用意しましょう。
狙う質問は、想像で作るよりも、お客様の実際の言葉から作るほうが確実です。自社サイトを訪れたお客様が検索した言葉は、AIに聞く質問とよく似ています。当社のECサイト向けエージェンティックコマースAI「genser」は、こうしたサイト来訪者の検索データ(インテントデータ)を集められます。お客様の言葉で狙う質問を決め、genrankでAIの答えへの出方を定点観測する、という組み合わせもできます。
AIの答えは、同じ質問でも日によって変わります。1回聞いて「出た」「出ない」で判断せず、続けて記録して、出る割合がどう変わるかを見てください。
よくある質問
AIのおすすめに自社の商品が出てこないのは、なぜですか?
AIが自社サイトを読めていないことが、原因の一つとして考えられます。robots.txt、CDN・WAF、ECカートのボット対策、ページやGoogleの設定、商品情報の表示のしかたの5か所を確かめてください。サイトが読めているなら、商品ページの書き方や、ほかのサイトでの紹介の少なさを疑ってみてください。
GPTBotを止めると、ChatGPTに出なくなりますか?
ChatGPTの検索の答えには、直接は影響しません。GPTBotは学習用で、ChatGPTの検索に使われるのはOAI-SearchBotです。OpenAIは、OAI-SearchBotを拒否したサイトはChatGPTの検索の答えに表示しないと説明しています。
robots.txtで何も拒否していないのに、AIに読まれないことはありますか?
あります。CDN・WAFのAI向けの設定や、ECカートの不正注文対策で止まっていることがあるためです。どちらも画面やrobots.txtからは分からないので、情報システム部門やカート事業者に確認してもらってください。
AIの学習に使われたくないと、AI検索にも出なくなりますか?
学習用だけを断れば、AI検索の答えに出る機会は残ります。OpenAIやAnthropicは、学習用と検索用でクローラーを分けているからです。Cloudflareを使っているなら、学習の設定は「Block」ではなく「Disallow AI Training」を選んでください。
GoogleのAIによる概要に自社サイトが使われているかは、どこで分かりますか?
Search Consoleで分かります。まず[設定]>[検索の生成AI]で、サイトが除外されていないか確認します。あわせて生成AIのレポートを見ると、AIによる概要やAIモードでの表示回数が分かります。
設定を直したら、どのくらいで効果が出ますか?
robots.txtの変更は、OpenAIとPerplexityの場合、反映まで1日ほどかかります。Search Consoleの設定は、通常数日で反映されるとGoogleは案内しています。AIの答えは日によって変わるので、数週間は記録を続けて変化を見てください。
まとめ
- AIに読まれていないECサイトは、おすすめの候補に入りにくく、公式サイトも出典になりにくい
- AIを止める原因はrobots.txtだけではない。CDN・WAF、ECカート、ページやGoogleの設定、商品情報の表示のしかたも確かめる
- robots.txt、Search Consoleの設定、商品ページの見え方は自分で確かめられる。それ以外は依頼文を使って担当者に頼む
- どのAIのアクセスを許可するかは、売り方に合わせた事業の判断。検索用とユーザー操作用は許可するのが基本
- 直した後は「読まれているか」「答えに出ているか」「お客様が来ているか」の3段階で成果を見る
AIの答えに自社が出ているか、計測から始めませんか
プレティアジャパンの「genrank」は、狙った質問に対するAIの答えのなかで、自社の言及や公式サイトの引用を計測するツールです。ブロックを直す前と後の変化も、同じ質問で比べられます。
- genrankの資料をダウンロードする
- お客様の言葉から狙う質問を作るなら:ECサイト向けエージェンティックコマースAI「genser」の資料をダウンロードする
- お問い合わせ
関連記事
- GEO・LLMO対策の5つのタイプ(計測ツール・改善提案・代行・EC基盤・内製)の違いと選び方
- 構造化データを足すだけでは、AIに引用されない――研究で分かったことと、本文とセットで整える5つのこと
- 検索ではなくAIに尋ねる時代、ブランドは何を準備すべきか
- AIにお得なドラッグストアは?と相談したら、言及率と引用率で首位が変わった
出典
確認日は1〜9が2026年11月9日、10と11が11月10日です。
- OpenAI「Overview of OpenAI Crawlers」:GPTBot・OAI-SearchBot・ChatGPT-Userの役割、反映に約24時間、IPアドレス一覧
- Anthropic「Does Anthropic crawl data from the web, and how can site owners block the crawler?」:ClaudeBot・Claude-SearchBot・Claude-Userの役割、サブドメインごとの指定
- Perplexity「Perplexity Crawlers」:PerplexityBotとPerplexity-Userの役割、robots.txtの扱い、WAFの許可設定、変更の反映に最大24時間
- Google「Google の一般的なクローラー」:Google-Extendedは検索への掲載・順位に影響しないこと
- Google 検索セントラル「AI 機能とウェブサイト」:nosnippetなどでAI機能に使う範囲を制限できること
- Search Console ヘルプ「検索の生成 AI の設定」:設定の場所、引き継ぎ、反映に数日、順位には使わないこと
- Cloudflare「Your site, your rules: new AI traffic options for all customers」(2026年7月1日):Search・Agent・Trainingの3分類
- Cloudflare「Have it both ways: stay discoverable in search while disallowing AI training」(2026年9月15日):Disallow AI Training、Blockの変更、旧設定の移行
- Vercel「The rise of the AI crawler」(2024年12月):主要AIクローラーがJavaScriptを実行していないこと、米国のデータセンターから来ていること
- W3Techs「Usage statistics and market share of Cloudflare」:Webサイトの25%がCloudflareを使っていること(2026年9月4日の発表)
- 開発者の報告「Traffic from ChatGPT jumped! Is it because its crawlers now run JavaScript?」(DEV Community):2026年9月25日から、OAI-SearchBotとGPTBotが著者のサイトでJavaScriptを実行し始めたという報告。個人のサイトのログにもとづくもので、OpenAIの公式発表ではない